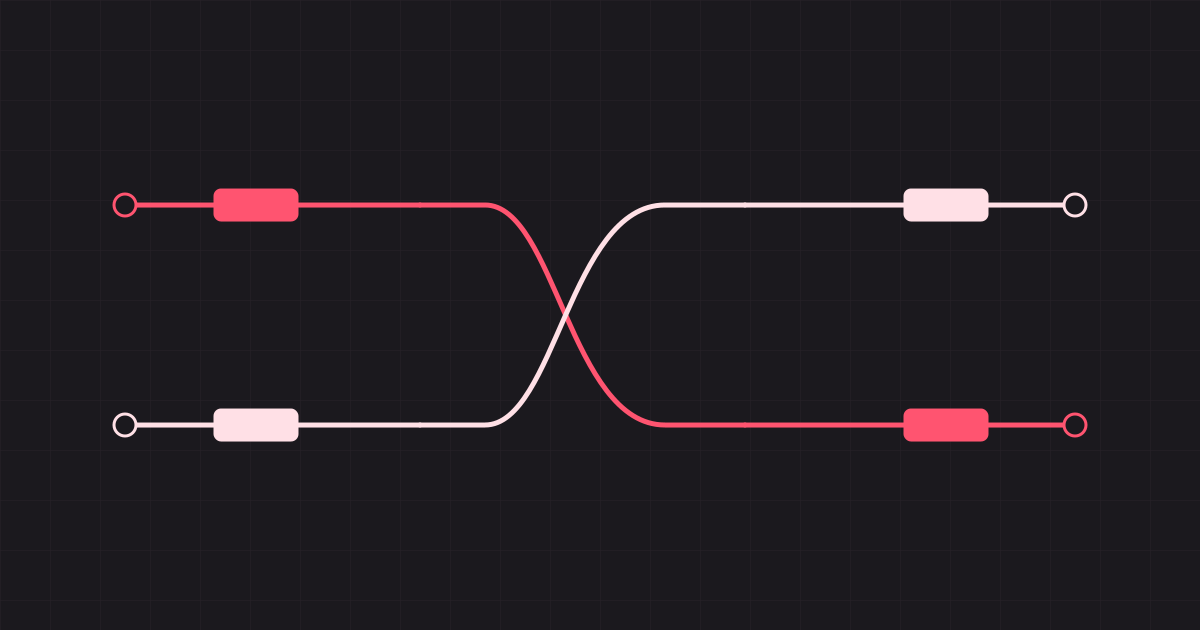
RecombiText untersucht, wie sich begrenzte Textkorpora für das Training von Sprachmodellen erweitern lassen. Im Mittelpunkt steht ein statistisches Framework, das Textdaten semantisch rekombiniert, statt zusätzliche Datenquellen oder generative Modelle zur Augmentation vorauszusetzen.
Umsetzung
- Konzeption und Implementierung eines statistischen Frameworks zur semantischen Rekombination von Textdaten in Low-Resource-Szenarien.
- Entwicklung einer Pipeline zur bis zu vierfachen Erweiterung von Trainingsdatensätzen.
- Durchführung von Pretraining- und Fine-Tuning-Experimenten mit Transformer-Modellen.
- Untersuchung daten-effizienter Trainingsansätze unter Einsatz von GPT-2, RoBERTa, T5 und Hugging Face Trainer.
Forschungsbeitrag
Die Arbeit wurde im Rahmen des BabyLM Workshops 2025 veröffentlicht. Sie untersucht, wie sich statistisch erzeugte Trainingsdaten auf die Fähigkeiten vortrainierter Sprachmodelle auswirken. Die Ergebnisse der Veröffentlichung zeigen Verbesserungen in ausgewählten Benchmarks und vergleichbare Leistungen in weiteren Aufgaben – keine pauschale Überlegenheit synthetischer Daten.
Technologien
Python, PyTorch, Hugging Face Transformers / Trainer, NumPy, pandas, scikit-learn und Elasticsearch.